Podcast · Conversación
Dos GeneracionesEl podcast de una tía y su sobrina, con cada episodio contado por capítulos y al segundo
Sitio del podcast de una tía y su sobrina: 58 episodios con ficha y capítulos al segundo, perfiles de las hosts con fuentes y un blog que cita al minuto.
Tecnologías
- Astro 7
- TypeScript
- MDX
- Zod
- CSS sin framework
- GSAP + ScrollTrigger
- WebGL (GLSL)
- @astrojs/sitemap
- sharp
- YouTube (youtube-nocookie)
- Node.js + sirv
- Docker
- Railway
- Google Analytics 4
- Microsoft Clarity
58
fichas de episodio
687
capítulos con marca de tiempo
7
temas para filtrar
67
URLs en el sitemap
Mi rol
Diseño y desarrollo del sitio en Azirgo SAS: identidad visual a partir de la portada del canal, modelo de contenido de los episodios, sincronización con YouTube, SEO técnico y despliegue.
El problema
Dos Generaciones es un podcast ecuatoriano de conversación: Doménica Tabacchi, de la Generación X, y su sobrina Giovanna, centennial, comparan cómo se ve la vida según la época en que creció cada una y reciben invitados con historias reales. Sale un episodio cada jueves, pero todo vivía en YouTube, Spotify e Instagram: un buscador no puede leer una conversación de una hora, y nada explicaba quiénes son ellas ni por qué el programa funciona entre dos épocas. Hacía falta una casa propia que ordenara los episodios por tema, los contara por capítulos y se mantuviera al día con el canal sin reescribir a mano lo que YouTube ya sabe.
Qué construí
- Home que cuenta el concepto: tía y sobrina en el hero, un carrusel con todos los episodios que avanza solo y se detiene en cuanto alguien le da play, un collage con fotos del set, tres pilares, los más vistos, un bento con los siete temas y preguntas frecuentes.
- /episodios con los 58 episodios, filtro por tema, buscador por invitado o por tema y paginación de 12 en 12; el tema y la página quedan en la URL para poder compartirlos.
- Una ficha para cada uno de los 58 episodios: resumen, una cita textual que enlaza al segundo en que se dijo, una tarjeta «En corto», quiénes se sentaron a la mesa y capítulos con marca de tiempo que arrancan el reproductor justo ahí.
- /hosts en tono informal - cómo se presenta cada una, lo que confesaron en el polígrafo, datos curiosos y lo que dice una de la otra - y un perfil detallado por host con su historia, línea de tiempo, galería, frases con su fuente y los episodios en los que más se abre.
- Blog con artículos que parten de uno o varios episodios y enlazan cada cita al minuto exacto del video del que sale.
- Contacto sin backend: el formulario arma el mensaje según el motivo - proponer un invitado, contar una historia, auspicios o prensa - y lo lleva al canal que exista: WhatsApp con todo escrito si hay número o, si no, lo copia y abre el mensaje directo de Instagram.
- Una imagen social de 1200x630 por página, 67 en total, generada por script con las tipografías de la marca, el logotipo y una foto enmarcada, además de los favicons.
Cómo está estructurado
Astro 7 en modo estático, con URLs sin barra final, servido por un servidor Node mínimo con sirv dentro de un contenedor Docker en Railway. Las páginas salen de tres capas de contenido que se cruzan por número de episodio, y ninguna depende de una API en el momento del build.
- Rutas: inicio, /episodios y 58 fichas en /episodios/<slug>, /hosts y dos perfiles en /hosts/<slug>, /blog y sus artículos, /contacto y una 404 propia; /host y /host/<slug> redirigen a las rutas en plural.
- Capa de YouTube: un JSON con el título, la fecha, la duración, las vistas y la descripción de cada video, más su miniatura en WebP en dos tamaños: la grande para el reproductor y una de 400 px para la tira del carrusel.
- Capa editorial: título limpio, invitado y uno de siete temas por episodio. La descripción de YouTube se limpia de saludos fijos, enlaces y hashtags antes de usarse como resumen.
- Fichas en MDX validadas con Zod: número, bajada, capítulos con su segundo de inicio, «En corto», temas, invitados con su retrato, marcas y la cita con quién la dice y en qué segundo; el cuerpo del archivo es el resumen.
- Datos estructurados en un solo grafo: Organization, WebSite y WebPage desde el layout; PodcastSeries, Person y FAQPage en el home; PodcastEpisode con VideoObject y sus capítulos como Clip en cada ficha; ProfilePage y Person en los perfiles; CollectionPage con ItemList en los listados; Blog y BlogPosting en el blog; ContactPage en contacto; BreadcrumbList en las páginas internas.
- Canonical, sitemap y robots.txt toman el dominio de una variable de entorno en el build. El sitemap sube la prioridad del home y de /episodios, y el robots.txt da la bienvenida explícita a GPTBot, PerplexityBot y ClaudeBot.
- Caché: lo que lleva hash se guarda un año y el resto revalida contra su ETag, porque sin cabecera el edge de Railway aplicaba cuatro horas y una foto cambiada tardaba en verse. GA4 y Clarity no se cargan en localhost ni en IPs de la red local.
Dos épocas, una identidad
El concepto del programa - una tía de la Generación X y su sobrina centennial - guía tanto el diseño como el contenido. Los colores se muestrearon de la portada del canal: café moca, cacao, crema, arena y rosa. Allura, la cursiva del «Dos» del logotipo, resalta una palabra en los titulares, con Cormorant Garamond para los titulares y DM Sans para el texto.
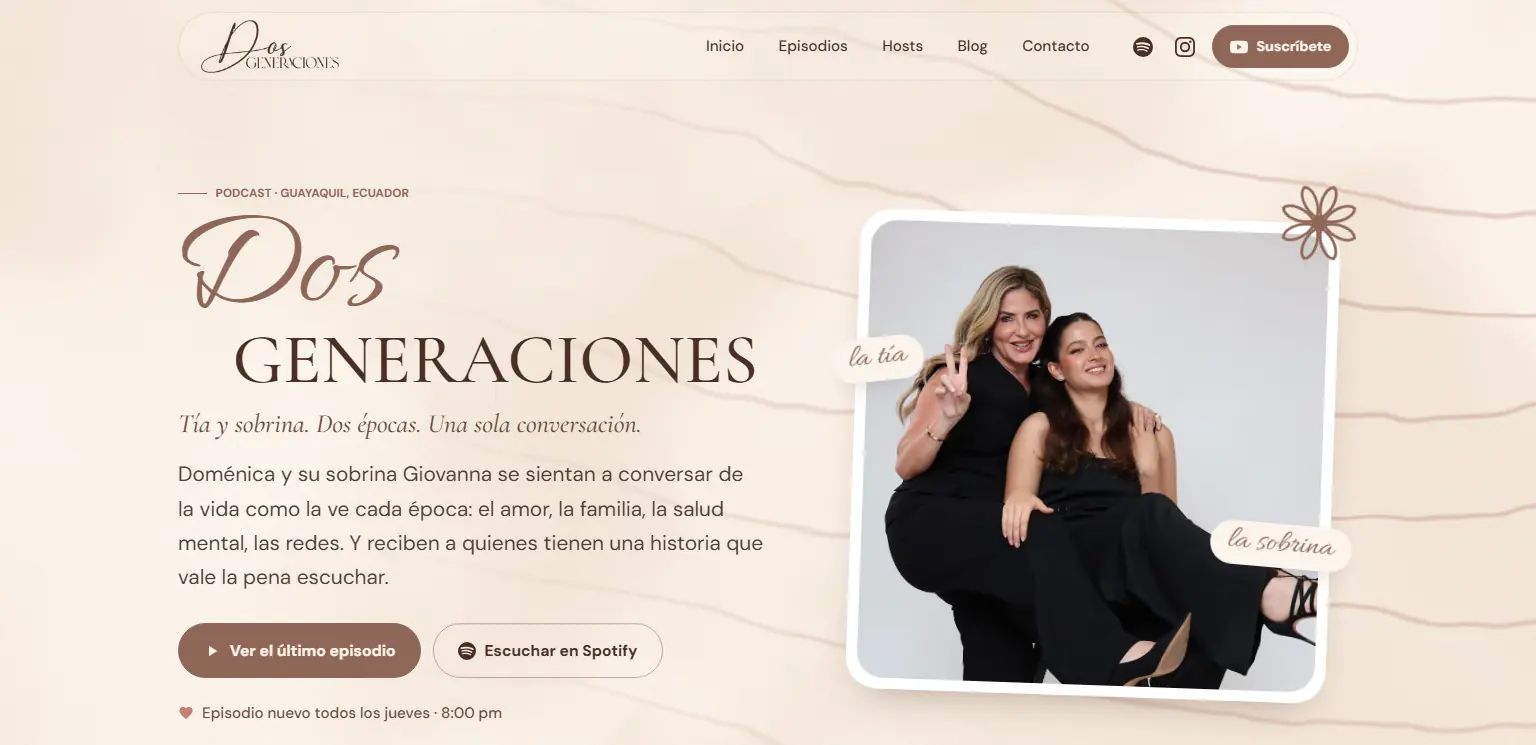
- El hero junta el nombre del programa, la frase «Tía y sobrina. Dos épocas. Una sola conversación.» y una foto de las dos con dos rótulos en cursiva: «la tía» y «la sobrina».
- El programa se ordena en tres pilares - lo de antes vs. lo de ahora, historias que inspiran y la persona detrás del personaje - y ocho rasgos del tono de cada conversación.
- En /hosts, los datos curiosos se intercalan tía, sobrina, tía, y la página cierra con lo que dice una de la otra. En los datos estructurados, cada host está vinculada con la otra y las dos figuran como fundadoras del programa.
- Las fotos del set son fotogramas reales de los episodios; las de stock solo aparecen en el blog, siempre con el crédito del fotógrafo.
- Fondos animados con un shader GLSL: una seda cálida con líneas onduladas como las de la portada del canal, que también avanzan con el scroll.
Por dentro del sitio
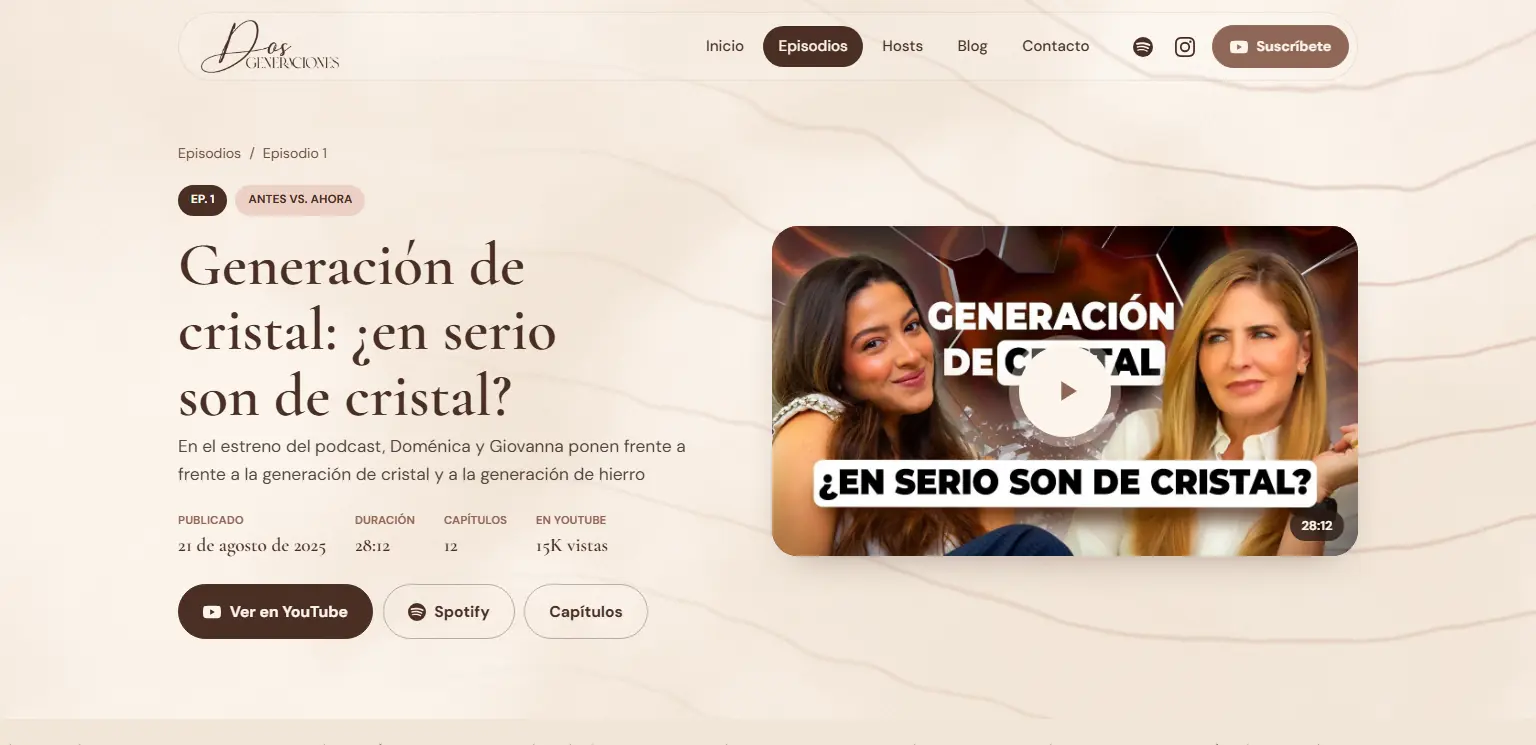
Ficha de episodio con el video, la duración y los capítulos. 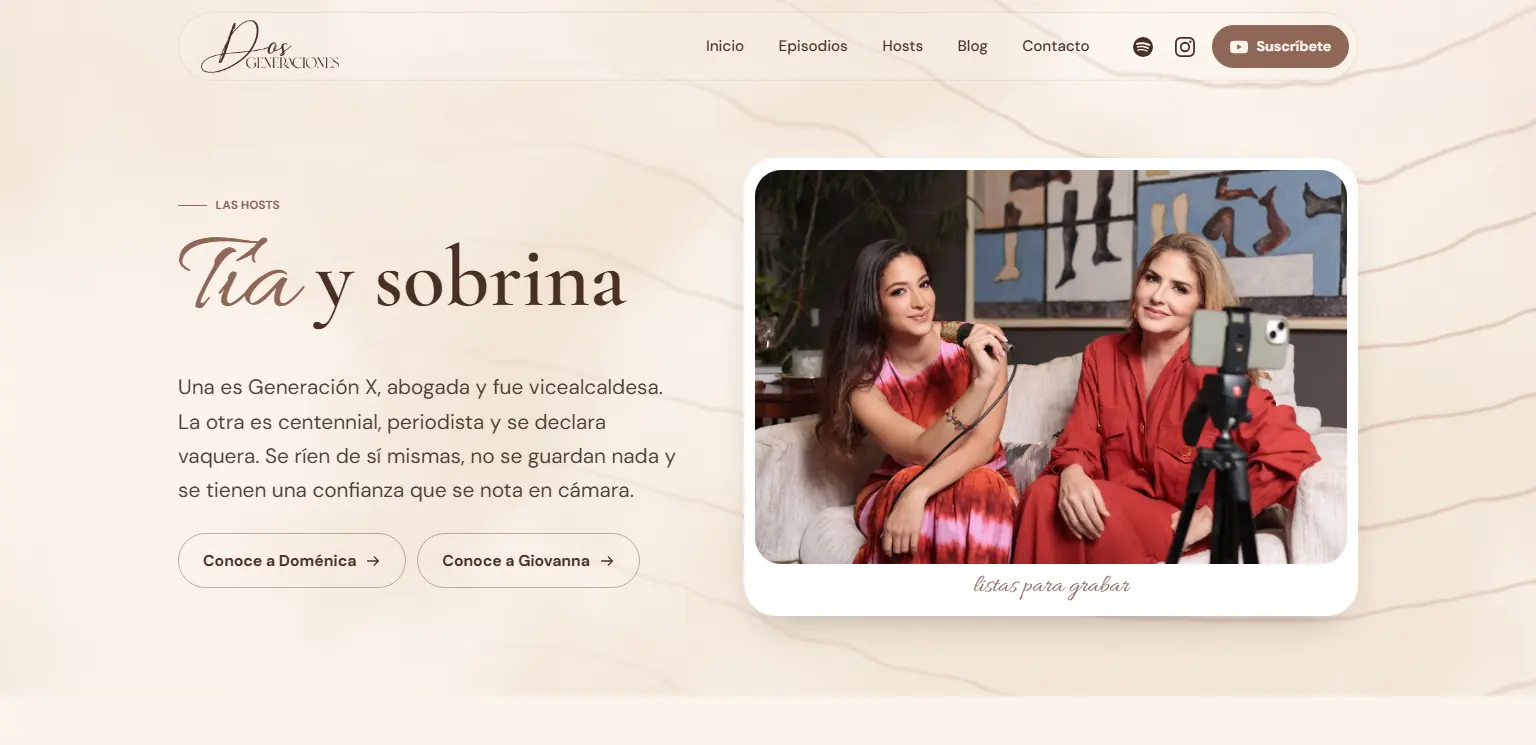
Página de las hosts: la tía y la sobrina.
Decisiones técnicas
- Los datos de cada episodio vienen de dos fuentes separadas a propósito: lo que dice YouTube - título, fecha, duración, vistas y descripción - lo escribe un script en un JSON que no se edita a mano, y lo editorial - título corto, invitado y tema - va aparte, por número de episodio. Así se puede volver a sincronizar sin perder nada, y un episodio sin línea editorial sale igual, en «Especiales».
- El build no llama a YouTube: usa los episodios ya sincronizados en el repositorio, así que desplegar no depende de que YouTube responda. La sincronización recorre la lista de subidas del canal con los mismos endpoints que usa su web, sin clave de API, descarta los Shorts por duración y solo publica los videos que llevan número de episodio en el título.
- Nada inventado: los capítulos llevan el segundo real del video, las citas son textuales y cada dato de las hosts declara su fuente - un episodio, una nota de prensa o una biografía pública -. Fechas, duraciones y vistas salen de YouTube, y las cifras del home se cambian a mano, anotando la fecha en que se tomaron.
- El reproductor es una fachada: miniatura y botón hasta el play, y recién ahí monta el iframe de youtube-nocookie. Las marcas de tiempo arrancan ese mismo reproductor en su segundo sin salir de la página, y en los datos estructurados cada capítulo es un Clip del VideoObject, para que pueda aparecer como momento clave en los resultados de búsqueda.
- Todas las fotos y miniaturas del sitio son WebP de menos de 100 KB, y un chequeo previo hace fallar el build si alguna no cumple. Las imágenes sociales son la excepción de formato - JPG, también bajo 100 KB -, porque WhatsApp, LinkedIn e iMessage no muestran la vista previa si og:image es WebP; y si una cambia, se le cambia también el nombre, porque las redes la guardan por URL.
Retos
- Escribir 58 fichas desde las transcripciones, con 687 capítulos anclados al segundo real del video. El endpoint de transcripciones de YouTube responde 400 sin sesión, así que se tomaron del panel del propio video, y el episodio que no tenía subtítulos se transcribió en local con Whisper, por tramos de dos minutos.
- Ponerle cara a cada invitado sin fotos de stock: los retratos se recortan de fotogramas reales del episodio y, cuando la persona no aparece en ellos, de la hoja de previsualización del video, con fotogramas de 320x180.
- Llevar a la web una marca cálida y en movimiento - seda animada con las líneas onduladas de la portada del canal, fotos que se enderezan con el scroll, texto que se enciende palabra a palabra - sin castigar la carga: el shader es WebGL sin librerías, todo respeta prefers-reduced-motion y la página se ve completa sin JavaScript.
Resultado
El sitio está en producción con los 58 episodios, cada uno con su ficha, los perfiles de las dos hosts, el blog y el contacto. Publicar un episodio nuevo es sincronizar el canal, sumar su línea editorial y su ficha MDX y volver a desplegar; el sitemap declara 67 URLs y cada una tiene su propia imagen social.