Medios · IA y automatización
Poder en los MediosPortal de noticias con un pipeline de IA que lee la prensa, agrupa cada historia y la redacta
Portal de noticias de Ecuador con un scanner de IA que lee 20 medios, agrupa la misma historia por similitud semántica y la redacta como nota propia.
Tecnologías
- Python
- FastAPI
- SQLAlchemy
- PostgreSQL
- Qdrant
- OpenAI API
- newspaper3k
- BeautifulSoup
- Next.js 16
- React 19
- TypeScript
- Supabase
- Tailwind CSS v4
- node-cron
- Zod
- Docker
- Railway
- Google Indexing API
- IndexNow
20
medios monitoreados
3 min
entre barridos del scanner
3.072
dimensiones por embedding
18
endpoints en la API del scanner
1.940
artículos en Actualidad
3.636
URLs en el sitemap
Mi rol
Desarrollador full stack en Azirgo SAS, en equipo con otro desarrollador, que inició el portal y armó en el scanner la base de embeddings, cola de trabajos y búsqueda por similitud. Yo construí los extractores por medio, la agrupación y la redacción con IA, el panel de monitoreo de la redacción, la integración con el portal (sincronización, publicación automática, imágenes e indexación) y las herramientas de IA del editor.
El problema
Un portal de noticias pequeño compite contra redacciones enteras. Cubrir el día exige leer decenas de portadas, darse cuenta de que cinco medios cuentan la misma historia, escribir una versión propia y publicarla antes de que la noticia se enfríe, sin copiar a nadie y sin perder el crédito de cada foto. Hacerlo a mano no alcanza, y automatizarlo sin control llena el sitio de duplicados, textos calcados e imágenes enlazadas a servidores ajenos.
Qué construí
- Scanner en Python que recorre en ciclos continuos, con 3 minutos de pausa entre uno y otro, las portadas y secciones de 20 medios, entre ellos El Universo, Primicias, El Comercio, Ecuavisa, Expreso, Extra, El País, BBC Mundo, CNN en Español e Infobae, con un extractor dedicado para cada uno.
- Extracción de título, cuerpo, fecha, sección de origen, pie y crédito de la foto, con un detector de créditos que reconoce agencias (EFE, AFP, Reuters, Getty…) e instituciones aunque el pie esté escrito de mil formas.
- Embeddings de cada nota con OpenAI indexados en Qdrant, más una tabla con los vecinos más parecidos de cada artículo y su puntuación.
- Agrupación automática: las notas de distintos medios que cuentan el mismo hecho se reúnen en un solo grupo, y las que llegan tarde se suman al grupo ya publicado.
- Redacción con IA de la versión más completa de cada grupo: nota propia en HTML con título SEO, sumilla, siete párrafos y tres intertítulos, sin inventar datos.
- API REST en FastAPI que expone los grupos listos para publicar, con cursor, filtro de pendientes y confirmación de envío.
- Sincronización en el portal Next.js: un cron que trae los grupos pendientes, vuelve a alojar la imagen en Supabase Storage, crea el artículo y avisa a los buscadores.
- Regla de publicación automática: si la foto viene acreditada a una agencia de prensa o a una institución pública, la nota sale publicada; si no, queda en borrador para la redacción.
- Replicador de Noticias: panel en vivo para la redacción con el feed por medio, aviso hablado de cada noticia nueva, búsqueda semántica y la misma historia vista en varios medios.
- Herramientas de IA en el editor del portal: título con verificación en la web, sumilla SEO, sugerencia de enlaces internos e imagen editorial generada.
Cómo está estructurado
Son tres proyectos independientes, cada uno con su repositorio y su despliegue en Railway con Docker, que se hablan por HTTP.
- news_scanner (Python 3.12, FastAPI, SQLAlchemy): un solo proceso con varios hilos. El principal corre los tres barridos, noticias, deportes y Mundial, uno tras otro y con 3 minutos de pausa entre ciclos; dos hilos (configurables) generan embeddings; otros dos agrupan y redactan, noticias cada 25 minutos y deportes cada 15; y Uvicorn sirve la API. Los datos viven en PostgreSQL, en 8 tablas, y los vectores en Qdrant.
- Poder en los Medios (monorepo con Turborepo): el portal en Next.js 16 sobre Supabase (PostgreSQL, Auth, Storage y RLS), el panel de administración y el cron que consume el scanner, que arranca dentro del propio servidor de Next.js. Un servicio FastAPI aparte alimenta la bolsa de empleo del sitio.
- Replicador de Noticias (Next.js 16, React 19): el panel interno de la redacción. No tiene base de datos propia: lee la API del scanner desde el navegador y usa dos rutas de servidor como proxy, una para la búsqueda semántica y otra para descargar imágenes.
- El scanner tiene dos salidas: los grupos de noticias generales, que consume este portal, y los de deportes, que consume otro portal del grupo con el mismo mecanismo.
Cómo se comunican las piezas
Todo el flujo es pull sobre REST: nadie empuja datos al portal, el portal los pide y confirma. El estado viaja en dos marcas, sent_to_cms en el scanner y external_id en el portal, así que cualquier paso se puede repetir sin duplicar nada.
- Barrido: cada extractor lee hasta 20 enlaces de la portada del medio, salta las URLs ya guardadas y se detiene en el primer título repetido. Cada nota nueva se guarda con su categoría y un hash SHA-256 de título y cuerpo; si el hash es nuevo, se encola un evento embedding.request en la tabla outbox.
- Indexación: los workers toman el evento con FOR UPDATE SKIP LOCKED, piden el embedding, buscan los 15 vecinos más cercanos en Qdrant, guardan los pares en similar_articles y registran el vector. Hasta 3 intentos por evento; si Qdrant no responde, el evento vuelve a la cola sin gastar intentos.
- Agrupación: cada 25 minutos se toman las notas ya indexadas de los 6 medios ecuatorianos habilitados, con al menos 1.000 caracteres y 30 minutos de antigüedad. Se agrupan con similitud de 0,72 o más, se redacta la más completa y el grupo queda en published_news_articles con sent_to_cms vacío.
- Consumo: el portal llama a GET /published-news?unsent_only=true&limit=50 dos veces por hora, en punto y a los 45 minutos, entre las 09:00 y las 17:45, y cada hora en punto el resto del día, en hora de Ecuador, con un guardia que impide que dos pasadas se solapen. La respuesta se valida con Zod antes de tocar la base.
- Alta: slug único, imagen descargada y normalizada a 1200×900 con derivadas WebP en Supabase Storage, INSERT en articles con external_id y luego POST /published-news/{id}/mark-sent.
- Grupos ampliados: si un medio se suma tarde a un grupo ya enviado, el scanner vacía sent_to_cms; el portal lo recibe de nuevo, choca con el índice único de external_id y solo actualiza la lista de fuentes, sin tocar título, cuerpo ni slug.
- Publicación: lo auto-publicado avisa en paralelo a la Indexing API de Google, a IndexNow y al hub WebSub del feed. Los borradores esperan a un editor, que publica desde el panel y dispara el mismo aviso.
- Redacción en vivo: el Replicador consulta /articles/latest cada 30 segundos y, cuando cambia el id, muestra una notificación y lee el titular en voz alta con la Web Speech API del navegador.
La IA en el flujo
La IA hace trabajos distintos con modelos distintos, y ninguno decide por sí solo qué se publica.
- Embeddings: text-embedding-3-large de OpenAI, 3.072 dimensiones, sobre título y cuerpo de cada nota. Sale un vector en Qdrant con distancia coseno y los pares de similitud. Es lo que permite reconocer la misma historia contada con otras palabras en otro medio, algo que ninguna comparación de títulos consigue.
- Búsqueda semántica: el mismo modelo convierte en vector lo que escribe la redacción en el Replicador, y Qdrant devuelve los artículos más cercanos de las últimas horas con su porcentaje de similitud.
- Redacción de noticias: un modelo GPT configurable, gpt-5.4-nano por defecto, vía Chat Completions. Recibe título, sumilla y cuerpo del artículo más completo del grupo; devuelve JSON con título, sumilla y un cuerpo HTML de 7 párrafos y 3 intertítulos, sin datos inventados ni rastros de transmisiones en vivo o de tuits. Si no cumple las longitudes, se le devuelve el error para que corrija, con 3 intentos en total.
- Deportes: el mismo modelo con un prompt de editor deportivo que convierte coberturas minuto a minuto en notas posteriores al partido, para la segunda salida del scanner.
- Título en el editor: la API Responses de OpenAI con un prompt versionado que consulta la web. Devuelve una propuesta y alternativas; si no puede confirmar el dato responde NO_CONFIRMADO y el título se queda como estaba, en lugar de rellenarse con algo inventado.
- Sumilla SEO: otro prompt versionado que recibe el título y la sumilla actual y devuelve una sumilla nueva junto con alternativas.
- Enlaces internos: gpt-3.5-turbo propone frases del cuerpo que merecen enlace; el portal busca en su propio archivo una nota que las cubra y enlaza solo las que encuentran destino.
- Imagen: gpt-image-1-mini genera una imagen editorial sin texto a partir del título, la sumilla y las indicaciones del editor, o la edita desde una foto de referencia, en 1536×1024 para la destacada o 1024×1024 para Instagram, y la sube directo a Supabase Storage.
Por dentro del sitio
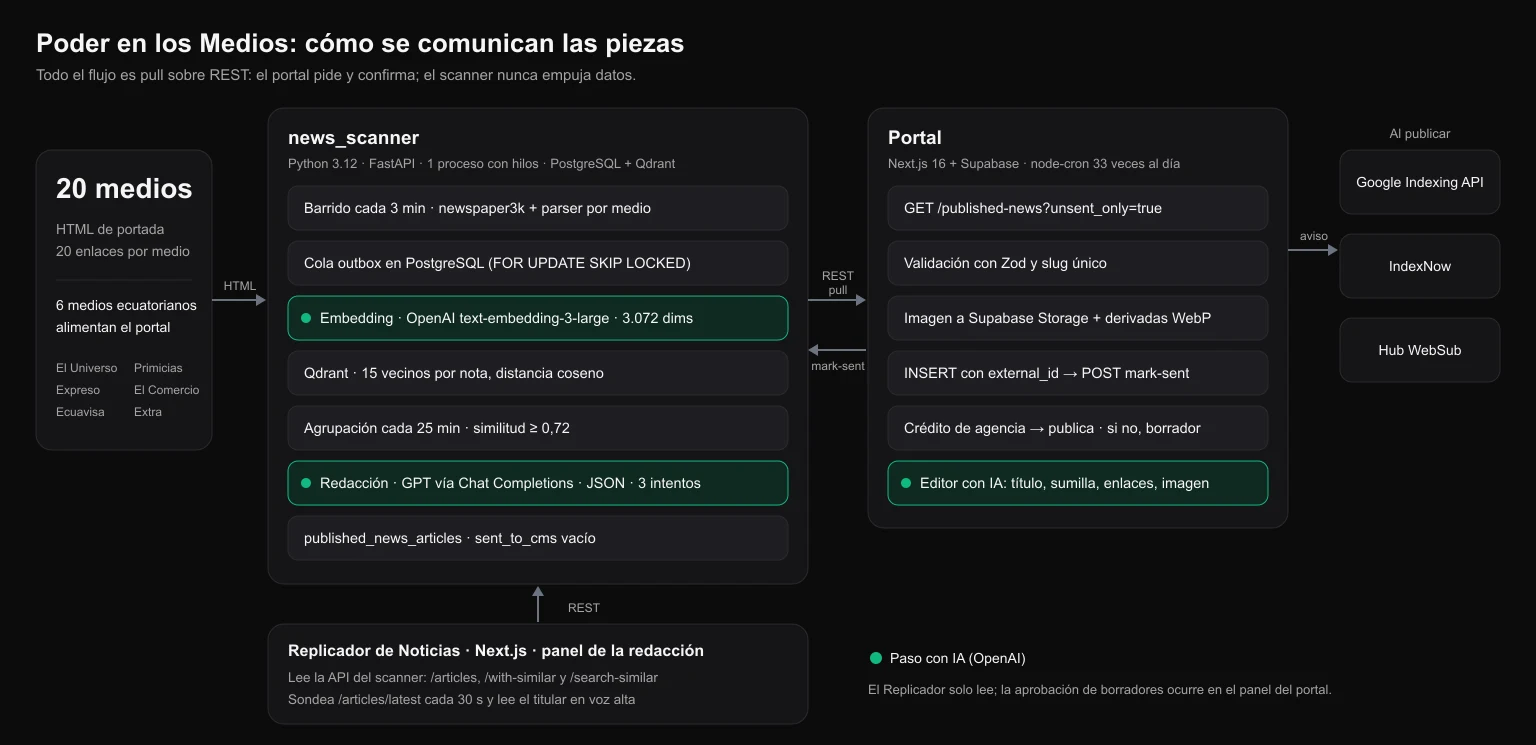
Diagrama: cómo se comunican el scanner, la IA, el portal y el Replicador. 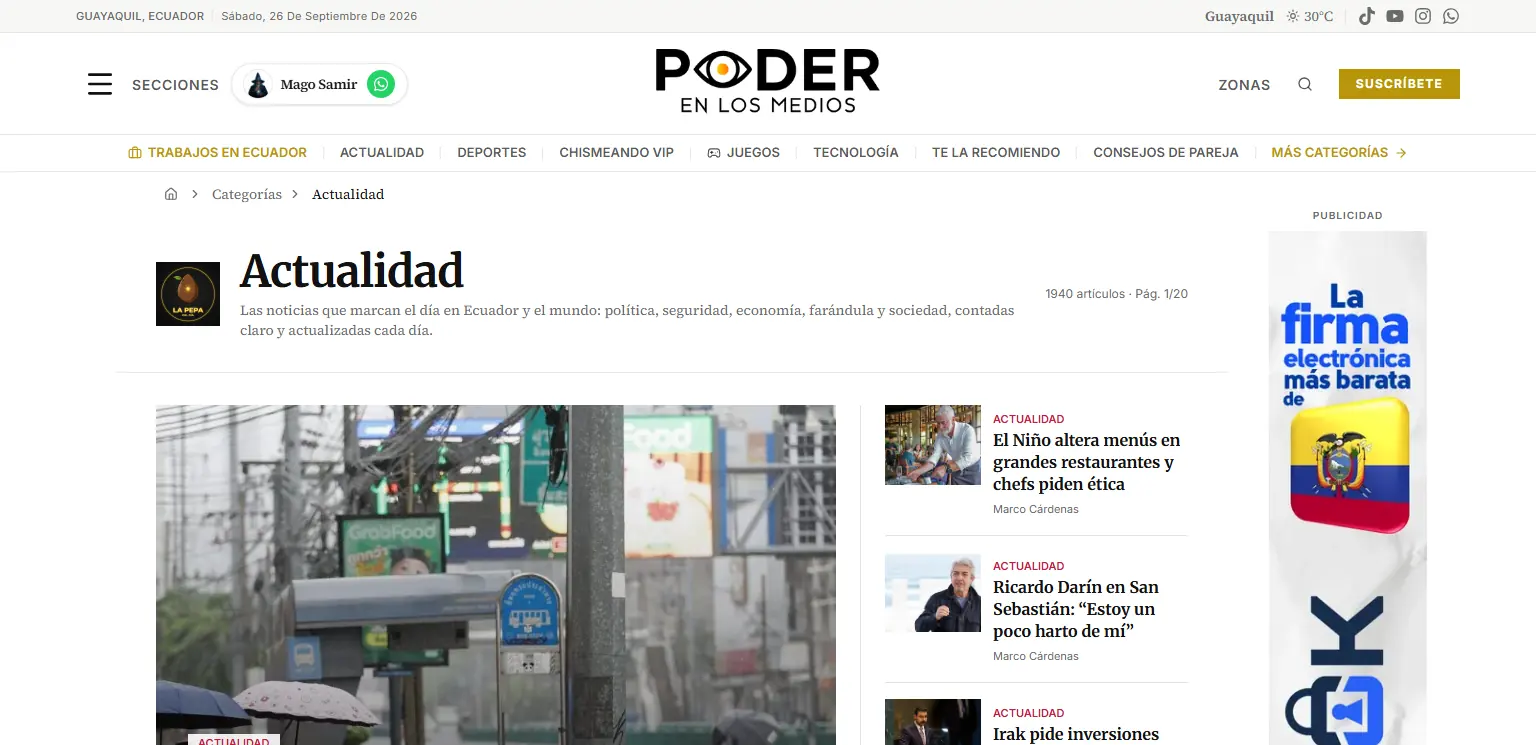
Actualidad, la sección que alimenta el pipeline del scanner. 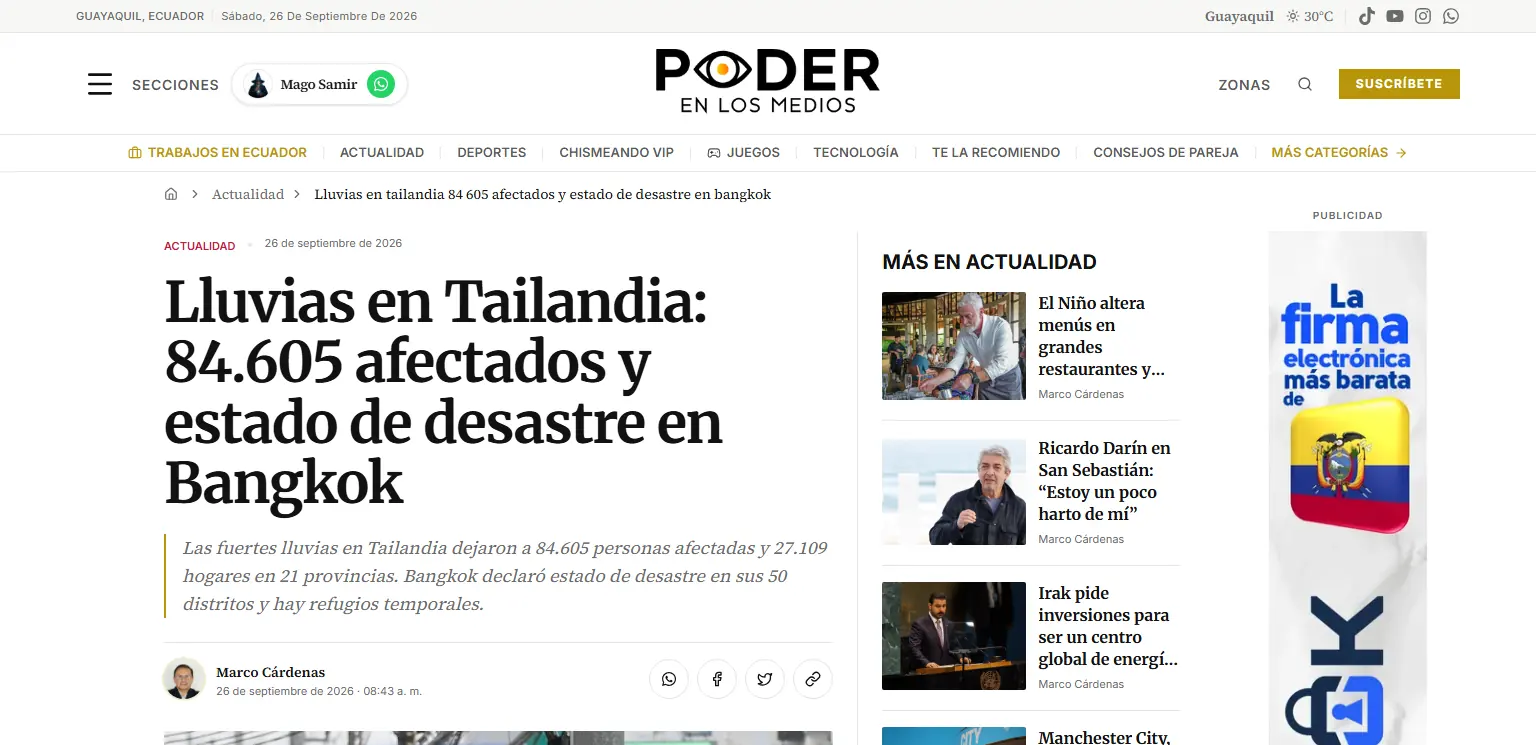
Una nota de Actualidad, con título y sumilla dentro de los límites del pipeline. 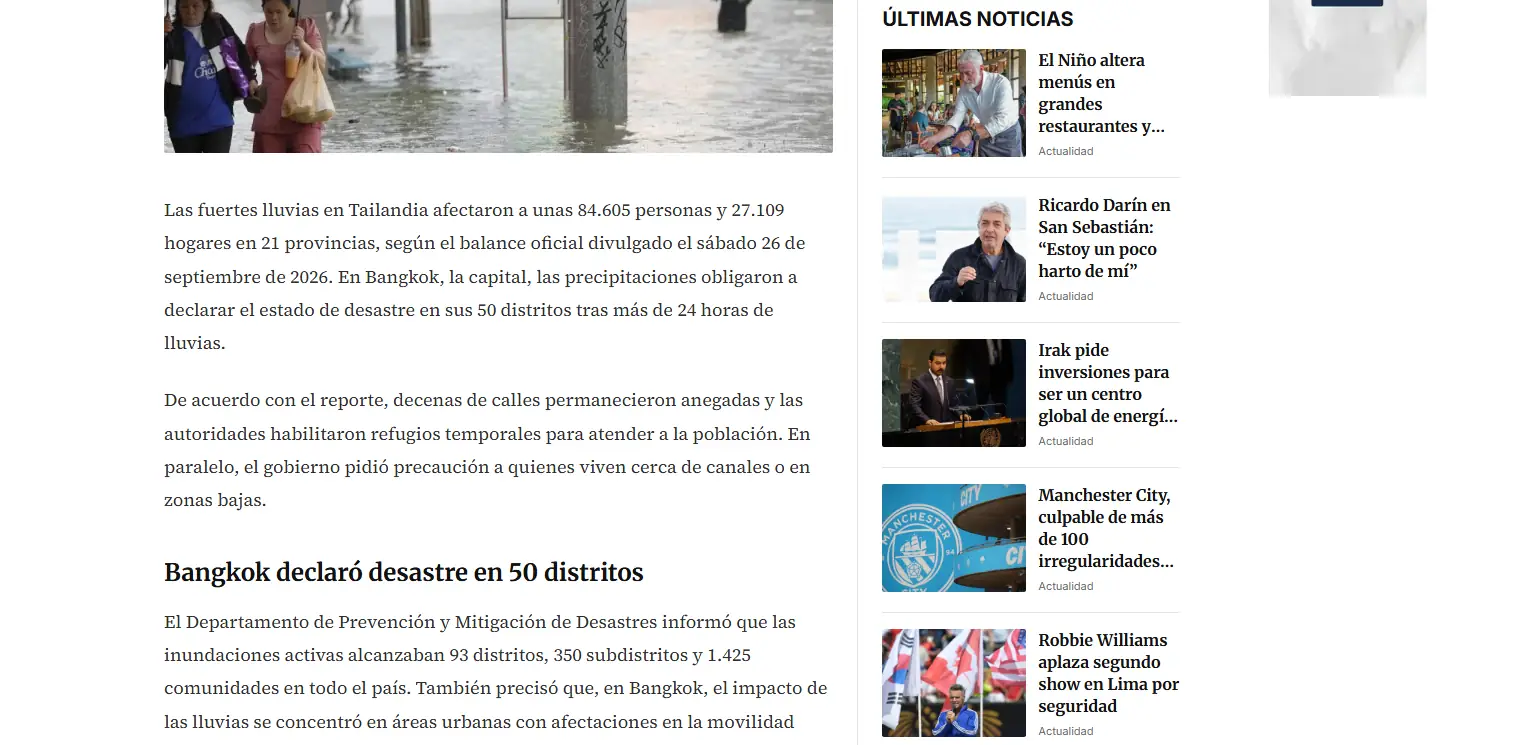
El cuerpo de la nota con la estructura que pide la redacción con IA: párrafos e intertítulos. 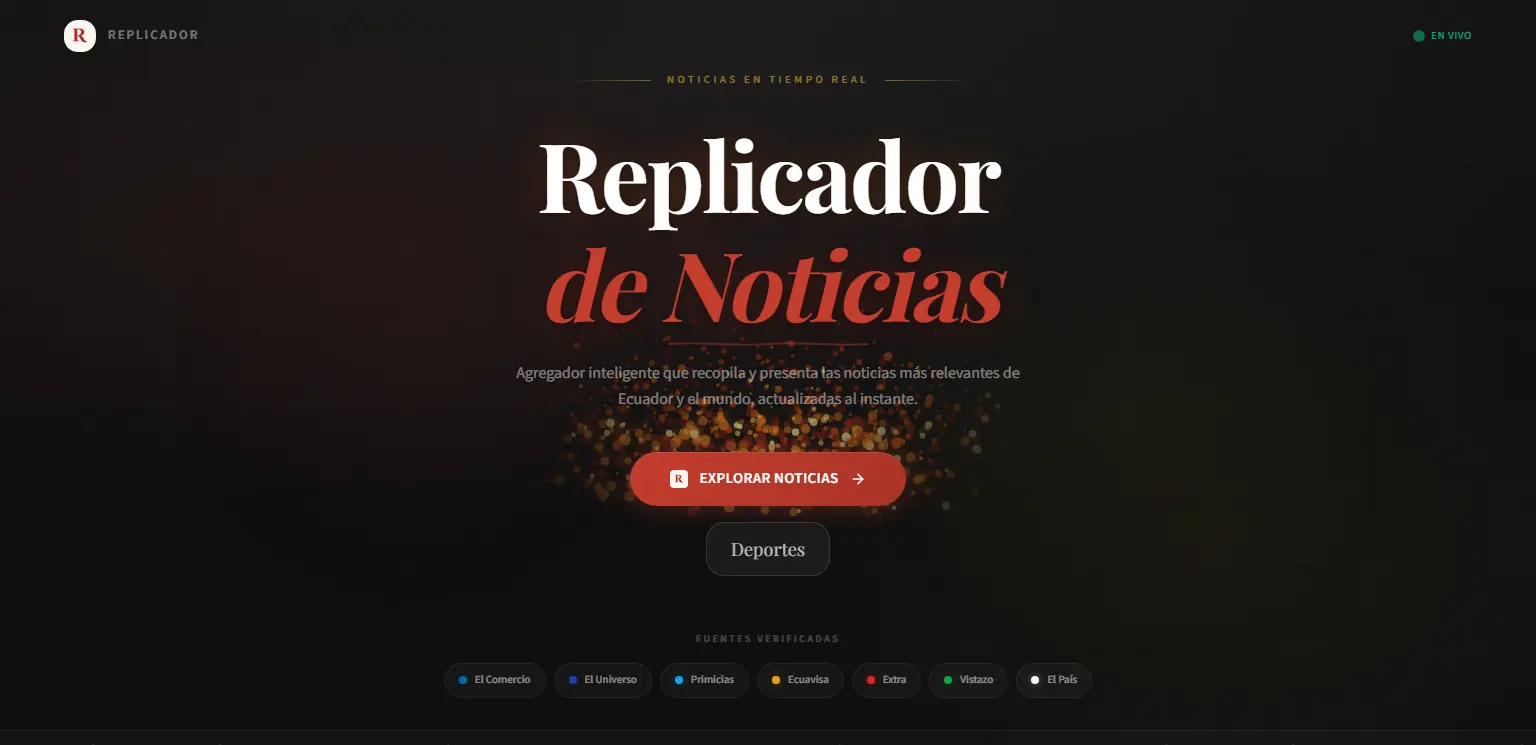
Replicador de Noticias, el panel interno de la redacción (en local, con datos de ejemplo). 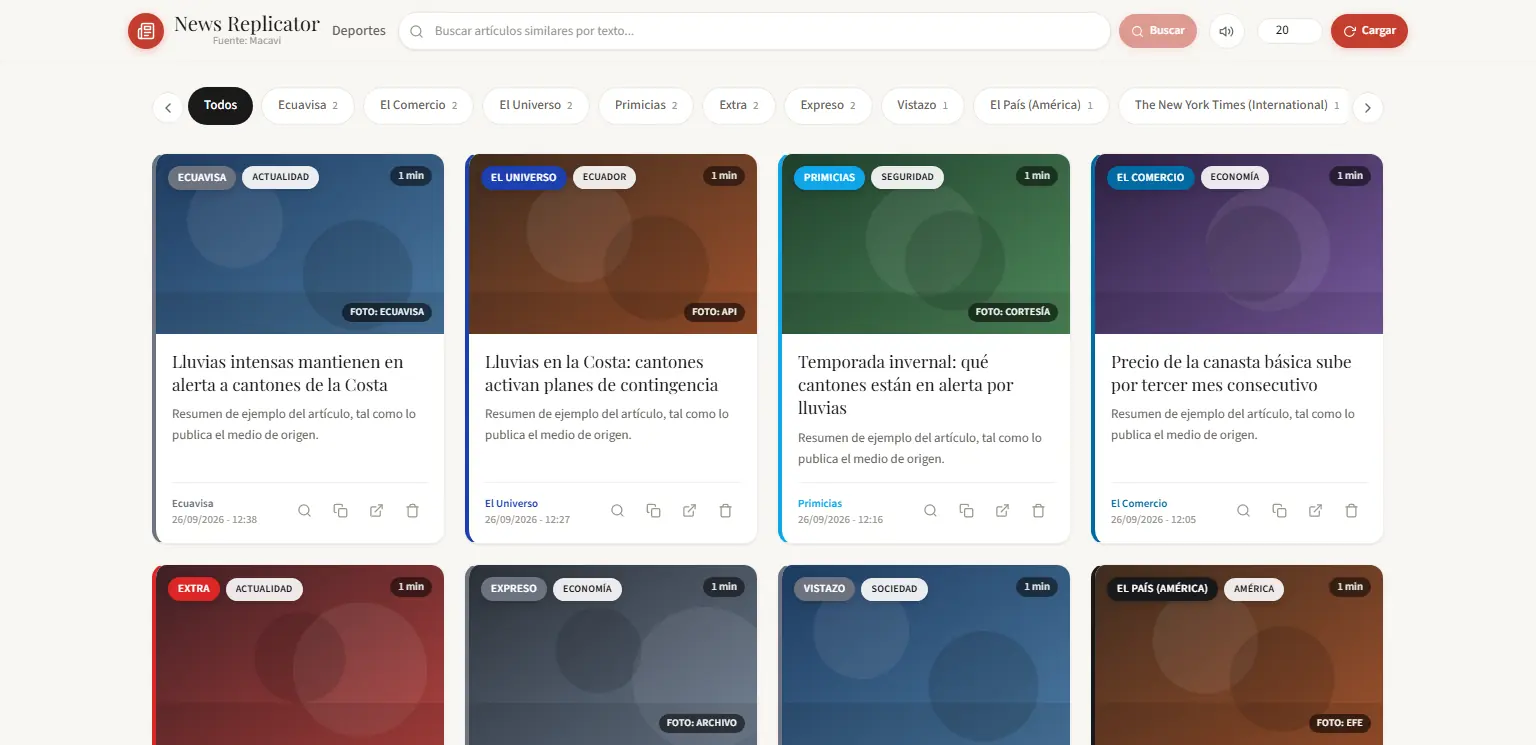
Feed en vivo por medio, con sección de origen y crédito de la foto (datos de ejemplo). 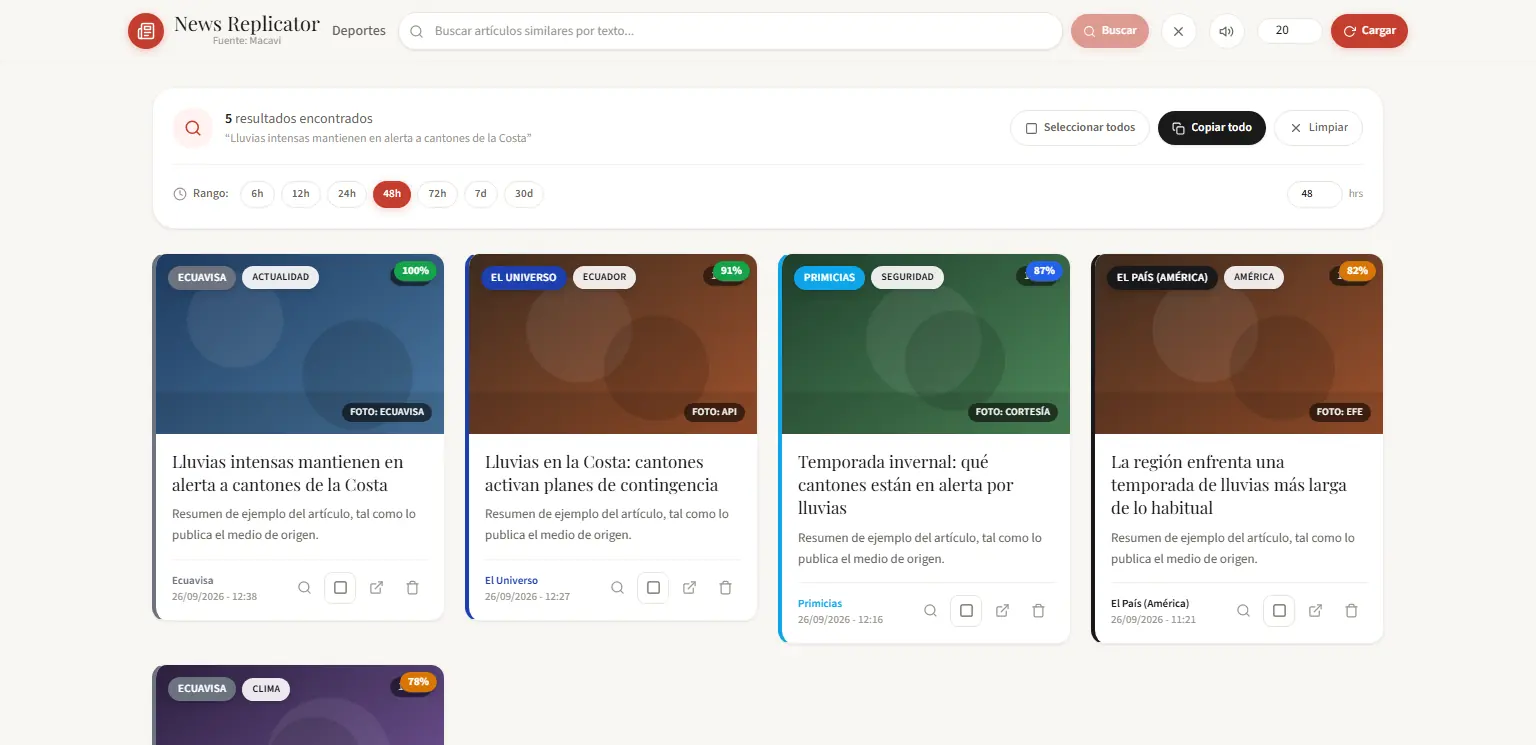
La misma historia en varios medios, ordenada por similitud semántica (datos de ejemplo).
El panel de administración
Cada módulo resuelve una parte de la operación diaria del negocio, sin salir del panel.
Extractores por medio
Un módulo por medio que lee su portada o sección, descarta lo ya guardado y se detiene en el primer título repetido.
Similitud semántica
Embeddings en Qdrant y una tabla de pares con puntuación que usan la agrupación, el panel y la búsqueda.
Agrupación
Reúne la misma historia contada por varios medios y suma a un grupo ya publicado las fuentes que llegan tarde.
Redacción con IA
Nota propia en HTML con título, sumilla, siete párrafos y tres intertítulos, validada antes de guardarse.
Sincronización
Cron del portal que trae los grupos pendientes, crea el artículo y confirma el envío al scanner.
Publicación automática
Sale sola la nota con foto de agencia o de institución pública; el resto queda en borrador.
Indexación inmediata
Cada publicación avisa en paralelo a la Indexing API de Google, a IndexNow y al hub WebSub del feed.
Replicador de Noticias
Panel en vivo de la redacción: feed por medio, aviso hablado, búsqueda semántica y historias relacionadas.
Decisiones técnicas
- Un outbox en PostgreSQL entre el scraper y los embeddings: el scraper nunca espera a OpenAI, y si Qdrant o la API se caen el trabajo vuelve a la cola en lugar de perderse. Los workers toman eventos con SKIP LOCKED para no pisarse.
- La similitud se calcula una sola vez, al indexar cada nota, y se guarda como pares con puntuación. La agrupación, el panel de la redacción y la segunda salida del scanner leen esa tabla en vez de volver a consultar el índice vectorial.
- Solo se redacta la versión más completa de cada grupo, la de cuerpo más largo: una llamada al modelo por historia, no una por medio.
- El modelo responde en JSON con límites duros, título de 45 a 70 caracteres y sumilla de 120 a 320. Si se sale, se le devuelve el error para que corrija, y como último recurso la sumilla se recorta en una frase completa.
- Integración por pull con confirmación: el portal pide lo pendiente y marca cada grupo como enviado. Un índice único sobre external_id hace que un reintento nunca duplique una nota.
- Qué se publica sin revisión lo decide una regla legible y sin dependencias, el crédito de la foto, no el modelo. Todo lo demás pasa por un editor.
- Las imágenes se descargan y se vuelven a alojar validando los bytes reales del archivo, porque muchos CDN responden con una página HTML y código 200 cuando bloquean el hot-linking.
Retos
- Cada medio arma su HTML a su manera: hubo que escribir un extractor por medio y resolver casos como un sitio que no declaraba su codificación en la cabecera y dejaba las tildes rotas en miles de artículos.
- Calibrar el umbral de similitud para que dos notas del mismo hecho se agrupen sin fundir historias distintas, y esperar 30 minutos antes de agrupar para que el resto de medios alcance a publicar la suya.
- Que una fuente que publica horas después se sume al grupo ya enviado sin pisar el título ni el texto que la redacción está editando en el portal.
- Leer el crédito de la foto en pies escritos de formas muy distintas, «Foto: EFE», «Foto AFP» o la agencia suelta al final, sin confundir el resto de la frase con un nombre, porque ese crédito decide qué se publica solo.
Resultado
El portal mantiene al día su sección de Actualidad con notas que el pipeline encuentra, agrupa y redacta. Las de agencia y de fuentes oficiales salen publicadas solas, con la imagen alojada en el propio sitio y aviso inmediato a Google, IndexNow y WebSub; el resto llega al editor como borrador ya redactado y con sus fuentes identificadas. La redacción trabaja desde un panel en vivo que le avisa de cada noticia nueva y le muestra la misma historia en varios medios, en lugar de revisar portadas una por una.